Essas últimas semanas, tivemos algumas polêmicas envolvendo Anthropic e até mesmo o GitHub relacionado ao plano de acesso deles. Desde “problemas” no Claude Code como rotear para modelos mais fracos, ou mesmo GitHub removendo a opção de assinatura para novos usuários. Será que estamos chegando no MURO das IAs? A Bolha está para estourar??
Planos do Claude Code e GitHub removendo planos de assinatura
Enquanto eu estava escrevendo esse artigo, tivemos algumas mudanças no GitHub Copilot. O GitHub Copilot precisou pausar novas inscrições em alguns planos, apertar limites, remover modelos caros de tiers mais baratos e migrar para cobrança baseada em uso. A justificativa é simples: agentes de programação não se comportam como chatbots tradicionais. Uma pergunta curta e uma sessão autônoma de horas não podem custar o mesmo para sempre.
O Claude Code passou por tensão parecida. A Anthropic testou remover o Claude Code do plano Pro para uma pequena parcela de novos usuários, incentivou uso fora do horário de pico, ajustou limites durante períodos de maior demanda e chegou a reduzir o esforço padrão de raciocínio para diminuir latência e consumo de tokens — uma decisão depois revertida por piorar a percepção de qualidade.
Ou seja, estamos ficando sem o poder computacional infinito, talvez estamos chegando finalmente no tal Muro?
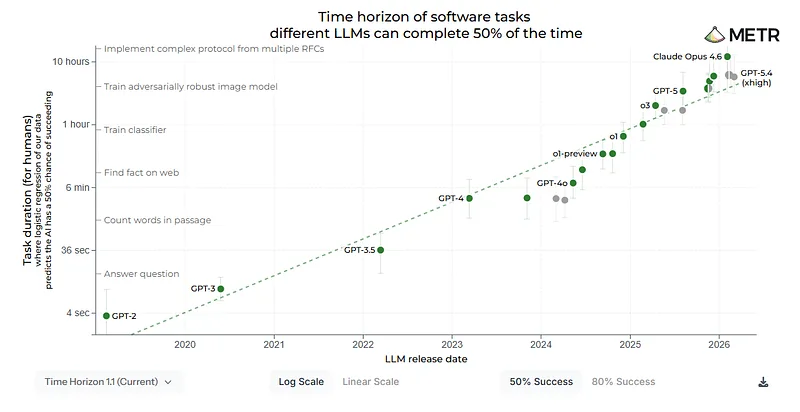
Mas o que raios é o Muro de IA?
O tal muro da IA, é um ponto onde os modelos vão começar a evoluir em uma frequência menor do que agora, não em exponencial dupla conforme os modelos estavam melhorando no passado. Ou seja, daqui em diante os modelos não darão saltos tão grandes como foi do 3.5 para o 4o ou do 4o para o 5, esse ultimo não foi tão gigante assim.
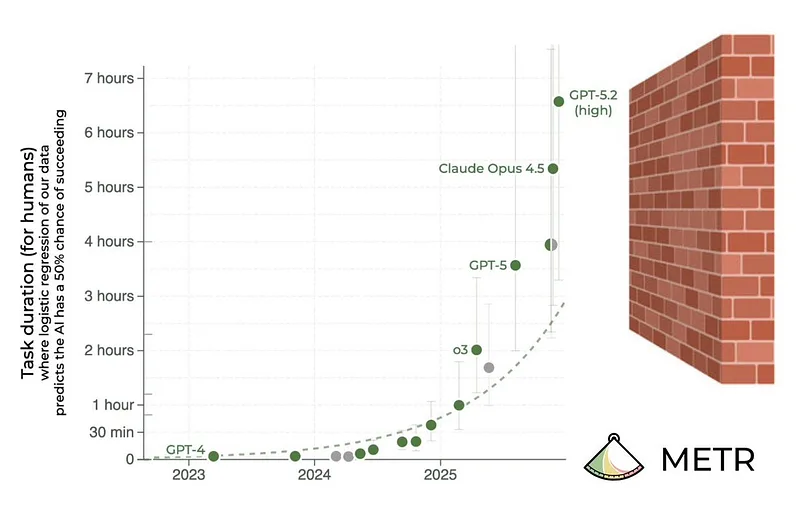
Para que os modelos continuem evoluindo nesse ritmo acelerado, que é essa curva de exponencial dupla representada pelos modelos na imagem do meme acima, precisamos de pelo menos 4 etapas fundamentais.
- Dados de Treinamento: Textos, imagens, videos, qualquer coisa criada por seres humanos que possam ser utilizados como treinamento para os modelos.
- Infraestrutura: Basicamente são os Datacenters. Quanto mais GPUs e servidores, mais conseguimos escalar os modelos.
- Eficiência Algorítimica: Aqui entra a capacidade de fazer modelos melhores gastando menos recursos — seja por arquiteturas mais eficientes, melhor uso de contexto, roteamento, compressão, quantização ou técnicas de inferência.
- Regulações: Essa etapa é relacionada a algo sobre limitações/regras que a pesquisa de AI pode ter.
Dados de Treinamento
Para você treinar um modelo de IA, você precisa de DADOS, muitos dados e de acordo com a Epoch AI estima que o estoque efetivo de texto público humano de boa qualidade está na ordem de 300 trilhões de tokens, com intervalo amplo, e projeta que esse estoque pode ser totalmente usado entre 2026 e 2032, ou antes se os modelos continuarem sendo supertreinados com muitos passes sobre dados parecidos. Já existem estimativas que esses dados já se esgotaram.
Com isso, sobra para as IAs Dados Sintéticos, se modelos futuros forem treinados indiscriminadamente em conteúdo gerado por modelos anteriores, pode acontecer o colapso do modelo: eles perdem caudas da distribuição, diversidade e começam a “não perceber” a realidade.
Infraestrutura
Esse é um problema que os Estados Unidos estão tentando resolver para a corrida da AGI, mas estão com vários problemas. Um jeito de você escalar um LLM pela força bruta, é aumentando o poder computacional dele. A Epoch analisou quatro grandes restrições para continuar escalando treinamento até 2030: energia elétrica, capacidade de fabricação de chips, escassez de dados e muro de latência. Ela ainda acha plausível chegar a treinamentos enormes até 2030, mas isso já entra em escala de gigawatts, data centers monstruosos e gargalos de rede/energia que parecem mais “obra de civilização” do que “treinar um modelinho no porão”. Além disso, agora o uso de IA está em alta, logo considerando as recentes controvérsias nos EUA sobre a criação de novos datacenters, os problemas relacionados ao Claude e o próprio CoPilot do GitHub, possivelmente se algum país for ganhar a corrida de escala, esse país vai ser a China.
Eficiência Algorítmica
Essa talvez seja uma das etapas mais difíceis do “muro” da IA. Podemos continuar escalando por força bruta, usando mais GPUs, mais energia, mais dados e até dados sintéticos, mas a pergunta central é: conseguimos tornar os modelos fundamentalmente mais eficientes e capazes?
Desde o artigo Attention Is All You Need, que consolidou o Transformer como arquitetura dominante, tivemos avanços importantes: Chain-of-Thought, técnicas melhores de prompting, RLHF/DPO, inference-time scaling, Mixture of Experts, roteadores de modelos, distilação, speculative decoding, otimizações de KV cache, long context e métodos recentes de quantização como TurboQuant. Porém, muitas dessas técnicas melhoram o uso, o custo ou a inferência dos modelos, sem necessariamente representar uma nova arquitetura tão transformadora quanto o Transformer.
Regulações
O avanço da IA não depende apenas de capacidade técnica. Mesmo que os modelos se tornem mais inteligentes, baratos e eficientes, eles ainda precisarão atravessar o muro regulatório. Esse muro não aparece da mesma forma em todos os países: nos EUA, a regulação tende a ser mais fragmentada e disputada entre governo federal, estados e empresas; na China, ela é mais centralizada e fortemente ligada a controle de conteúdo, segurança nacional e governança estatal; já a União Europeia segue um caminho mais formalizado e baseado em risco, com o AI Act em vigor desde 2024 e obrigações entrando em fases.
Essa diferença cria uma assimetria: quem tiver regras mais flexíveis pode experimentar mais rápido, escalar modelos com menos atrito e talvez sair na frente na corrida por sistemas cada vez mais autônomos. Mas essa vantagem vem com riscos: deepfakes, vigilância, discriminação, abusos comerciais, automação irresponsável e modelos capazes de agir além do que conseguimos auditar.
Pela corrida da AGI, quem tem menos regulações, vai poder realmente sair na frente, mas será que vai valer o risco de ter um modelo desalinhado para ser controlado, seja ele próximo ou não da AGI?
E a Bolha da IA? Vai estourar?
Agora que você entendeu onde está o Muro da Inteligência Artificial, dá para analisarmos o cenário de uma grande explosão.
Para que a bolha de IA não estoure, ou pelo menos não sofra uma grande correção, precisamos que várias coisas continuem funcionando em paralelo: a infraestrutura precisa continuar escalando, os custos de energia e chips precisam ser sustentáveis, novas inovações algorítmicas precisam continuar surgindo, as regulações precisam permanecer flexíveis o suficiente para permitir experimentação, e os dados sintéticos precisam ser bons o bastante para compensar o esgotamento gradual dos dados humanos disponíveis na internet.
É por isso que estamos vendo uma corrida por datacenters gigantescos, empresas buscando fontes próprias de energia, Big Techs investindo cifras absurdas em chips, governos tentando equilibrar inovação com segurança e laboratórios apostando cada vez mais em dados sintéticos, agentes, modelos especializados e raciocínio em tempo de inferência.
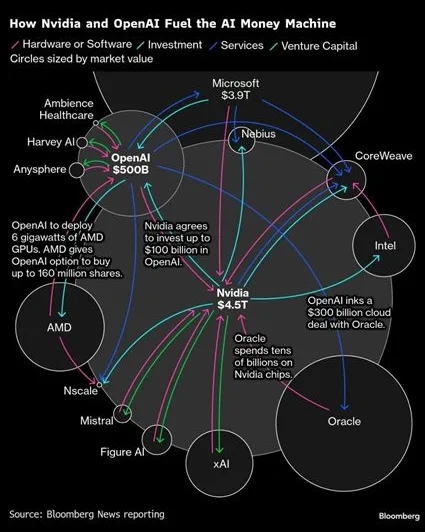
O problema é que o mercado parece estar precificando um futuro onde todas essas etapas serão derrubadas continuamente. E esse é o risco. Se apenas um desses pilares falhar, o crescimento pode desacelerar. Mas se vários falharem ao mesmo tempo — energia cara, chips escassos, regulação pesada, dados sintéticos ruins, poucos ganhos algorítmicos e modelos que não entregam retorno financeiro proporcional ao investimento — aí sim podemos ver o estouro de uma bolha. E talvez nem seja uma bolha comum, mas um verdadeiro buraco negro financeiro, sugando capital, energia, chips e expectativas. E é aqui que entra uma das discussões mais importantes, mas menos glamourosas, da IA moderna: a otimização de tokens.
Otimização de Tokens
No fim das contas, por trás de toda interface mágica, todo agente autônomo e todo “copiloto” inteligente, existe uma conta sendo paga. Cada mensagem enviada, cada documento lido, cada ferramenta chamada, cada passo de raciocínio e cada tentativa de resolver uma tarefa consome tokens. Tokens viram inferência. Inferência vira GPU. GPU vira energia. Energia vira custo. E custo vira o limite real entre uma tecnologia revolucionária e um produto economicamente inviável.
Talvez os Tokens sejam o petróleo invisível da IA moderna: ninguém vê queimando, mas toda resposta consome um pouco. Roteamento de modelos, compressão de contexto, RAG, cache semântico, modelos especialistas e técnicas melhores de prompt vão se tornar cada vez mais importantes.
O que muda para um desenvolvedor?
Com bolha ou sem bolha estourando, a tecnologia dos modelos de LLMs e agentes de IA veio para ficar. Dito tudo isso, vale continuar estudando sobre orquestração de agentes, mas não deixar o conhecimento de desenvolvimento de lado, arquitetura, código, pois você vai precisar muito disso no futuro, especialmente se os modelos começarem a ficar mais caros.
E lembrando para bolha estourar cedo, não é preciso que os modelos falhem, basta ela demorar um pouco mais do que estão prevendo para ela se pagar com ou sem AGI.
Referências
GitHub. Changes to GitHub Copilot Individual plans. 2026.
GitHub. GitHub Copilot is moving to usage-based billing. 2026.
Anthropic. An update on recent Claude Code quality reports. 2026.
Anthropic Support. Claude March 2026 usage promotion. 2026.
Epoch AI. Will we run out of data? Limits of LLM scaling based on human-generated data. 2024.
Epoch AI. Can AI scaling continue through 2030? 2024.
Shumailov et al. AI models collapse when trained on recursively generated data. Nature, 2024.
Vaswani et al. Attention Is All You Need. 2017.
Wei et al. Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. 2022.
Rafailov et al. Direct Preference Optimization. 2023.
Fedus et al. Switch Transformers: Scaling to Trillion Parameter Models. 2022.
OpenAI. Learning to reason with LLMs. 2024.
DeepSeek-AI. DeepSeek-V3 Technical Report. 2024.
Google Research. TurboQuant: Redefining AI efficiency with extreme compression. 2026.
European Commission. AI Act enters into force. 2024.
DigiChina / Stanford. Internet Information Service Algorithmic Recommendation Management Provisions. 2022.
China Law Translate. Interim Measures for the Management of Generative Artificial Intelligence Services. 2023.
Bloomberg. A Guide to the Circular Deals Underpinning the AI Boom. 2026.
MUFG. Complex Web of AI Corporate Cross-Holdings. 2026.