Semana passada, tivemos o lançamento do Anti Gravity e o Gemini Pro 3, logo depois o Codex Max 5.1 e essa semana (26/11/2025) temos o Opus 4.5 com um Benchmark superando os seus “adversários”. Mas o que, afinal, cada benchmark realmente mede? E como eles ajudam a entender se um modelo está melhor — ou, se preferir, mais próximo da tal AGI?
Benchmark em tradução livre fica como “ponto de referência”. No contexto atual, a palavra é muito usada como uma ferramenta de aferição de desempenho, seja de um produto, investimento ou um LLM. No nosso caso, eu vou explicar (ou pelo menos tentar) de maneira simples e direta, os principais benchmarks que aparecem nesses gráficos comparativos que tanto vemos nas redes.
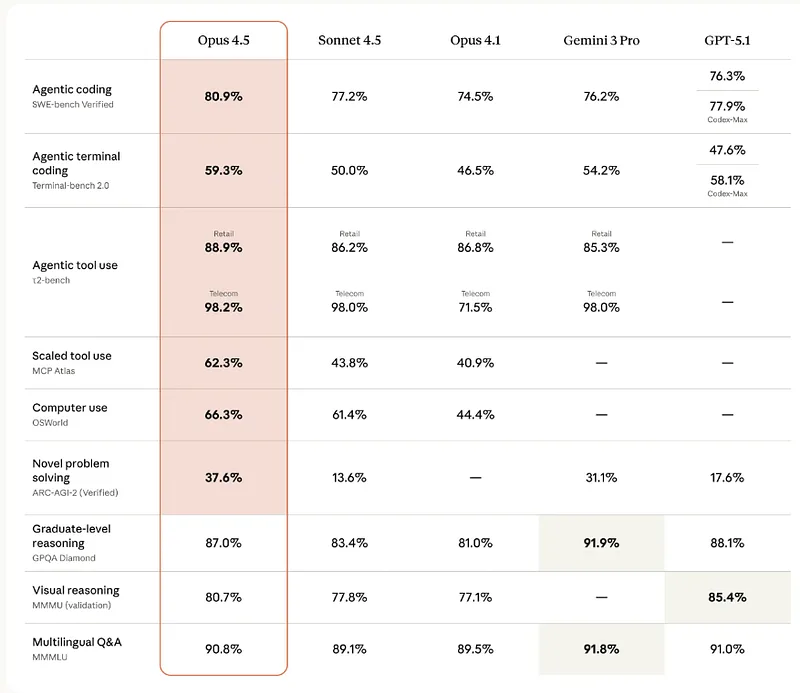
Agentic coding — SWE-bench
SWE vem do termo Software Engineer (Engenheiro de Software), basicamente esse benchmark avalia a capacidade de um modelo resolver tarefas reais em repositórios Python no GitHub. O modelo recebe o código do projeto, a tarefa e precisa propor uma correção que realmente resolve o problema.
Nesse caso, na avaliação de cima do Opus, teve mais ou menos um subconjunto com ~500 tarefas revisadas à mão, com testes e correções validados por humanos para evitar falsos positivos.
As tarefas podem ser amplas, mas elas costumam ser mais ou menos assim:
- “Esse teste está quebrando, conserte o bug.”
- “Essa função precisa suportar um novo parâmetro.”
- “Essa API está retornando o valor errado, ajuste a lógica.”
O agente deve:
- Entender a descrição da tarefa.
- Ler o código (às vezes vários arquivos).
- Editar arquivos corretos.
- Rodar testes e garantir que tudo passa.
Quando você pede para o CoPilot, Codex, Claude executar uma tarefa, ele precisa executar ela e ter uma resposta aceitável. É o mesmo aqui.
Um score acima de 80%, como o obtido pelo Opus 4.5, é impressionante.
Mas há limitações: o benchmark é focado em Python, depende de repositórios fixos e sempre existe o risco de “contaminação” — o modelo já ter visto partes do código durante o treinamento.
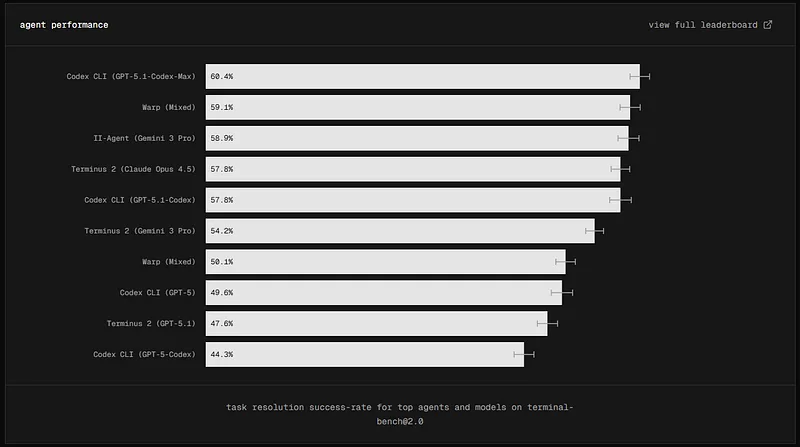
Agentic terminal coding — Terminal-Bench 2.0
Esse aqui é bem parecido com o SWE, mas a diferença é que ele roda como um Linux real pela linha de comando. Os cenários vão desde compilar projetos até treinar modelos de ML, configurar servidores e resolver dependências quebradas. Por exemplo, o agente consegue clonar um repo, instalar dependências, rodar testes e corrigir erros ou configurar um servidor web, ajustar firewall, subir serviço.
O agente precisa navegar no terminal (git, pip, sed, systemctl, etc.), editar arquivos com editores CLI e, no fim, deixar o ambiente no estado correto. Basicamente é o que você faz com o Claude Code/Codex Cli atualmente.
Uma pontuação alta em Terminal-Bench indica um modelo que consegue agir como “dev Ops full stack” no terminal, executando pipelines de ponta a ponta. Da mesma forma que o SWE tem suas limitações, o Terminal Bench, não consegue capturar cenários usando GUI (Interface Gráfica do Usuário) e os cenários por mais que sejam realistas, ainda são vários cenários em Docker, não necessariamente reflete o mundo real.
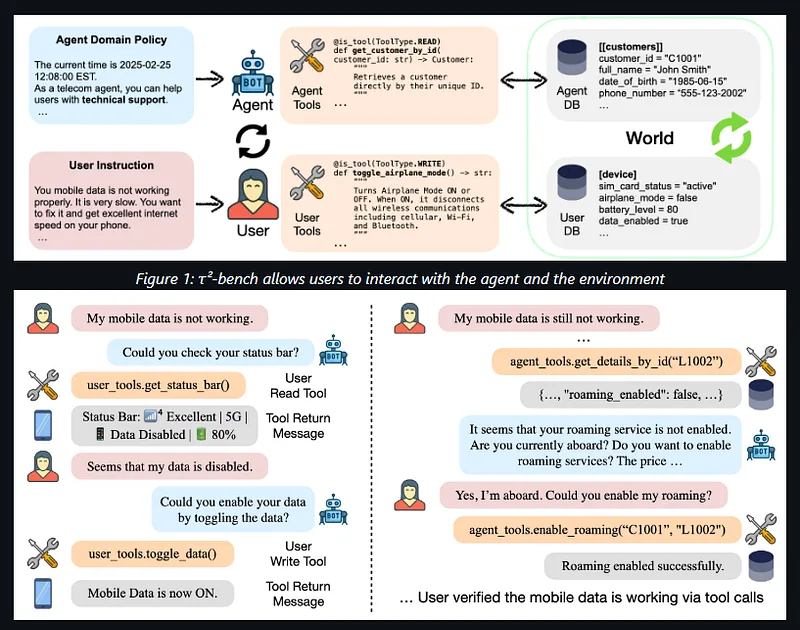
Agentic tool use — τ²-bench
τ²-bench (lê “tau-quadrado”) é um benchmark para agentes conversacionais que usam ferramentas em cenários de atendimento ao cliente, principalmente em domínios como varejo e telecom. Ou seja esse benchmark é especifico para ser usado como um ChatBot.
Esse benchmark avalia a capacidade do modelo de resolver problemas de cobranças, diagnosticar problema de conexão usando ferramentas de rede. No fim é importante para “agentes de call center”, chatbots corporativos.
Mas há limitações importantes:
- não mede interação com clientes confusos ou hostis,
- não testa ruído de voz,
- nem ambiguidade humana real.
É um benchmark ótimo para “chatbot ideal”, não para o caos do mundo real.
Scaled tool use — MCP Atlas
MCP Atlas é um benchmark feito pela Scale/SEAL para avaliar uso de ferramentas em larga escala através do Model Context Protocol (MCP). A ideia é medir como o modelo se sai quando tem acesso a muitas ferramentas diferentes (bancos de dados, APIs, buscadores, etc.) e precisa orquestrar chamadas em cadeias complexas.
Ele testa cenários onde o modelo tem acesso a:
- APIs,
- bancos de dados,
- buscadores,
- sistemas internos,
- cadeias de complexas de ações.
A pergunta aqui é:
O modelo sabe orquestrar várias ferramentas diferentes para resolver um problema complexo?
Como é recente, ainda não existe uma base de comparação tão sólida quanto em outros benchmarks.
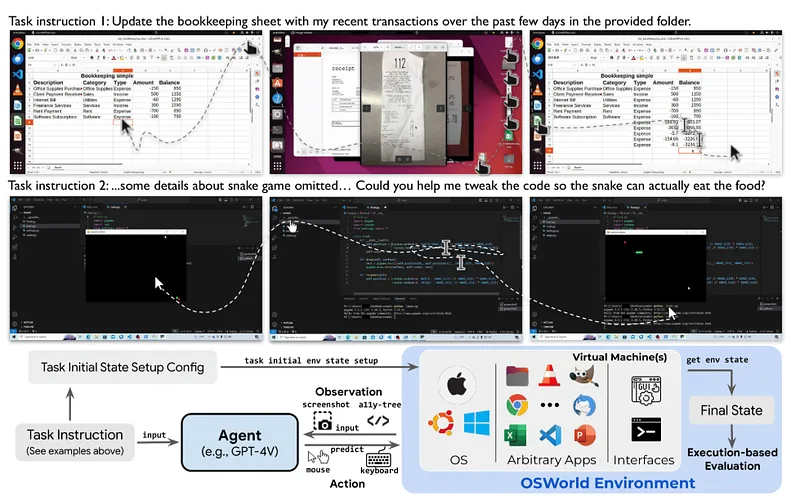
Computer use — OSWorld
OSWorld é um benchmark de uso de computador: o agente controla um desktop de verdade (ou ambiente simulado bem próximo) com apps como navegador, editor de texto, planilha, e ferramentas de sistema. As tasks são rotinas reais de trabalho, com múltiplos passos e janelas. Como:
- Baixar um arquivo da web, organizar em pastas, descompactar.
- Preencher planilhas, fazer gráficos e enviar por e-mail.
- Ajustar configurações do sistema, instalar programas, etc.
O benchmark mede se a tarefa foi concluída e, em versões mais novas, também a eficiência (quantos passos a mais o agente deu comparado a um humano). O problema é que as Interfaces podem mudar com o tempo, e há uma quantidade finita de tarefas.
Novel problem solving — ARC-AGI-2
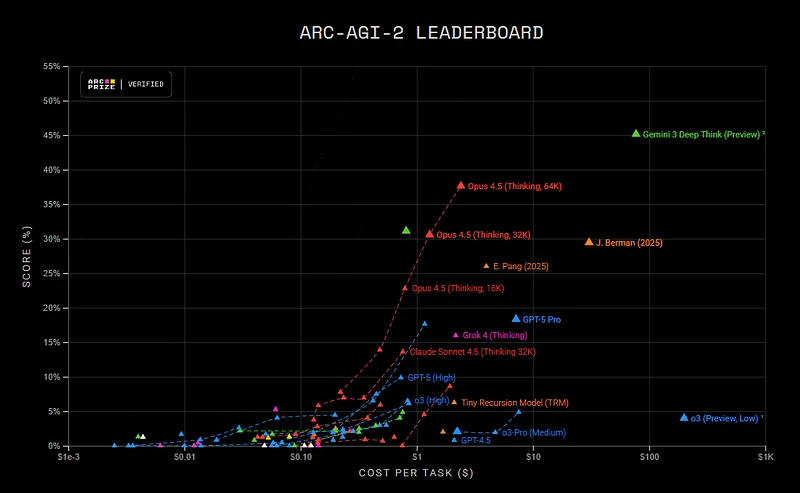
Esse é o mais “místico”, o mais hypado, o mais temido, o grande ARC-AGI! O ARC-AGI, criado pelo François Chollet, tenta medir razão abstrata e generalização forte, ou seja: a capacidade do modelo de inferir regras que não estão explícitas em texto, mas escondidas em padrões visuais.
Cada problema mostra pequenas grades de quadradinhos coloridos (input/output) e o modelo precisa inferir a regra implícita e aplicá-la em novos exemplos. O ARC-AGI-2 é a nova versão, ainda mais difícil, usada hoje como um “stress test” de sistemas rumo a AGI. O ARC-AGI-2 é ainda mais difícil e é usado como um stress test de “inteligência de sistema” — o famoso “o quão longe estamos da AGI?”.
Um humano “treinado” conseguiria em teoria resolver 100% do painel do ARC-AGI 2, entretanto se um modelo consegue resolver 45% como foi feito pela última versão do Gemini 3 Deep Think é algo fora da curva.
Mas é importante deixar claro, as tarefas que você visualiza no ARC AGI, não costumam “acontecer “na vida real. E o uso de ferramentas externas também impacta no resultado.
Graduate-level reasoning — GPQA Diamond
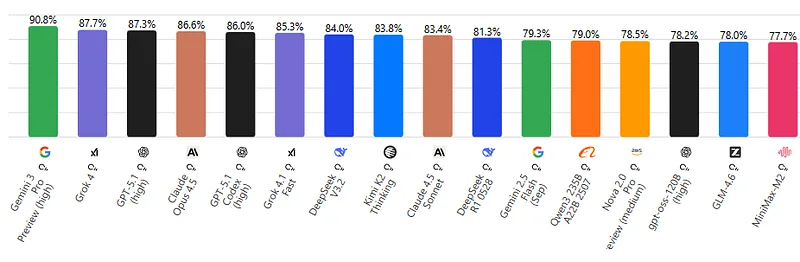
O GPQA é uma prova de múltipla escolha em física, química e biologia em nível de pós-graduação.
A versão Diamond é a elite da elite:
- questões difíceis,
- curadas manualmente,
- resolvidas apenas por especialistas PhD.
Uma boa nota significa que o modelo consegue lidar com raciocínios complexos e conteúdo avançado — algo como um “bom aluno de pós”.
O problema é que o foco fica somente em três áreas (física, química, biologia); nada de ciências humanas, engenharias específicas etc. E como é multipla escolha, limita a “criatividade” do modelo.
Visual reasoning — MMMU
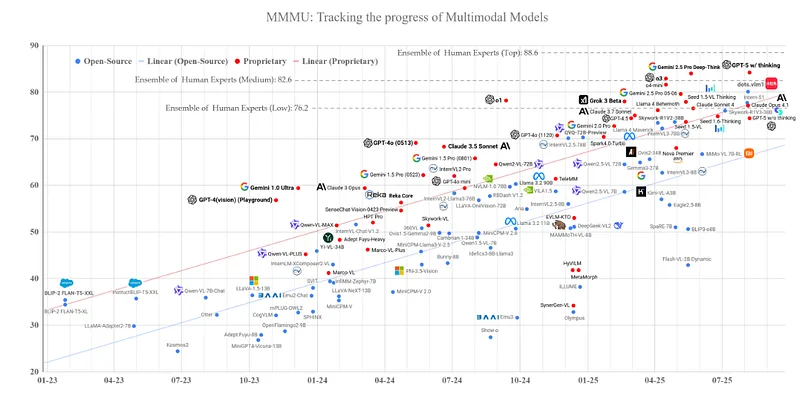
MMMU (Massive Multi-discipline Multimodal Understanding) é um benchmark multimodal que mistura imagem + texto em perguntas de múltipla escolha. Ele tem mais de 11 mil questões coletadas de provas, livros e quizzes de nível universitário em várias áreas (arte, negócios, medicina, ciências, engenharia, humanidades) e vários idiomas.
Um bom resultado indica que o modelo consegue raciocinar e recuperar conhecimento em vários idiomas, não só traduzir literalmente do inglês, mas também entender nuances culturais e contextuais.
O problema que traduções podem introduzir ruídos, ambiguidades ou diferenças culturais fora uma possibilidade de contaminação dos dados.
Conclusão
Benchmarks são essenciais para medir o progresso dos LLMs e entender onde cada modelo é mais forte.
Mas não existe um benchmark único que indique “proximidade da AGI”.
Cada teste mede um pedaço diferente da inteligência:
- alguns focam em capacidade prática,
- outros em raciocínio abstrato,
- outros em conhecimento técnico,
- outros em uso de ferramentas.
A interpretação correta exige olhar o conjunto, não um número isolado no gráfico. E é importante lembrar, mesmo com tudo isso, ainda não quer dizer que a AGI está logo ali, e sim que cada vez que um modelo faz uma pontuação mais alta que os anteriores, estamos um passo mais próximo dela. E ainda faltam muitos passos, muitos pra chegar lá.
Referências e links úteis
Agentic coding — SWE-bench (e variantes)
- Site oficial / overview:
https://www.swebench.com/ - Dataset original:
https://www.swebench.com/original.html - Repositório GitHub:
https://github.com/SWE-bench/SWE-bench
Agentic terminal coding — Terminal-Bench 2.0
- Repositório GitHub (terminal real, tasks de DevOps etc.):
https://github.com/laude-institute/terminal-bench - Leaderboard (modelos e scores):
https://artificialanalysis.ai/evaluations/terminalbench-hard
Agentic tool use — τ²-bench (tau-squared bench)
- Paper / descrição técnica (arXiv):
https://arxiv.org/abs/2506.07982 - Repositório GitHub:
https://github.com/sierra-research/tau2-bench - Página de pesquisa / overview:
https://sierra.ai/resources/research/tau-squared-bench
Scaled tool use — MCP Atlas
- Leaderboard oficial da Scale AI:
https://scale.com/leaderboard/mcp_atlas
Computer use — OSWorld
- Site oficial do benchmark:
https://os-world.github.io/ - Repositório GitHub:
https://github.com/xlang-ai/OSWorld
Novel problem solving — ARC-AGI / ARC Prize
- Página oficial do ARC-AGI:
https://arcprize.org/arc-agi - Site da ARC Prize Foundation (competição ligada ao benchmark):
https://arcprize.org/ - Repositório GitHub (dataset ARC original):
https://github.com/fchollet/ARC-AGI
Graduate-level reasoning — GPQA / GPQA Diamond
- Paper original (GPQA):
https://arxiv.org/abs/2311.12022 - Repositório oficial:
https://github.com/idavidrein/gpqa - Página de benchmark / leaderboard:
https://epoch.ai/benchmarks/gpqa-diamond
Visual reasoning — MMMU
- Site oficial do MMMU:
https://mmmu-benchmark.github.io/ - Repositório GitHub:
https://github.com/MMMU-Benchmark/MMMU - Paper (arXiv):
https://arxiv.org/abs/2311.16502
Multilingual Q&A — MMMLU / Multilingual MMLU
- Paper que discute MMMLU (MMLU-ProX, com seção sobre a variante multilíngue):
https://arxiv.org/abs/2503.10497 - Leaderboard / visão geral de modelos em benchmarks multilíngues:
https://huggingface.co/spaces/StarscreamDeceptions/Multilingual-MMLU-Benchmark-Leaderboard