Esses dias, Donald Trump anunciou duas coisas relacionadas ao universo da Inteligência Artificial. Uma delas é que os Estados Unidos não devem regular ou colocar barreiras no desenvolvimento de IA’s e a outra as IAs não devem ser “WOKE”. O que me trouxe dois pensamentos.
O primeiro, é que realmente estamos escalando para uma “Guerra Fria” de IAs, independente se vamos alcançar a tão sonhada Super Inteligência e o segundo, é que é a ordem executiva de um presidente de uma das maiores nações do mundo pode desalinhar Inteligências Artificiais. E eu acho o segundo, tão perigoso quanto o primeiro.
O problema é quando decidimos que uma IA deve “ser neutra por decreto” e pisa no acelerador sem checar segurança, a chance de desalinhamento só cresce. A “neutralidade como meta” é muito fácil de burlar e puxa o foco para a política, não para o risco real. O modelo aprende a passar no teste, não a ser justo de verdade. A ordem executiva de 23 de julho de 2025 manda as agências comprarem apenas IA “verdadeira” e “ideologicamente neutra”, o que desloca o foco de risco/segurança para sinalização política.
O que é desalinhamento em IAs
Mas quando alguém fala sobre desalinhamento de uma IA, o que isso realmente significa? Existe um exemplo bem clássico que pode ilustrar bem esse cenário. Vamos supor que você encontrou as 7 Esferas do Dragão, invocou o Shen Long — um dragão místico que pode te conceder qualquer desejo, imortalidade, riquezas, tudo está ao alcance dele! O que você pede? “Quero me tornar rico! Muito rico, o mais rico do mundo!”. Parece um pedido razoável certo? Entretanto Shen Long ao invés de gerar o dinheiro artificialmente, ele pega todo o dinheiro já existente no mundo e transfere para sua conta bancária. Você agora tem mais dinheiro que o Tio Patinhas, mas também virou o maior ladrão de todos os tempos.
Esse é um exemplo simples também conhecido como desalinhamento de objetivos (Goal Misalignment**),** onde um LLM não entende o objetivo original corretamente ou otimiza de uma maneira que o desenvolvedor não queria.
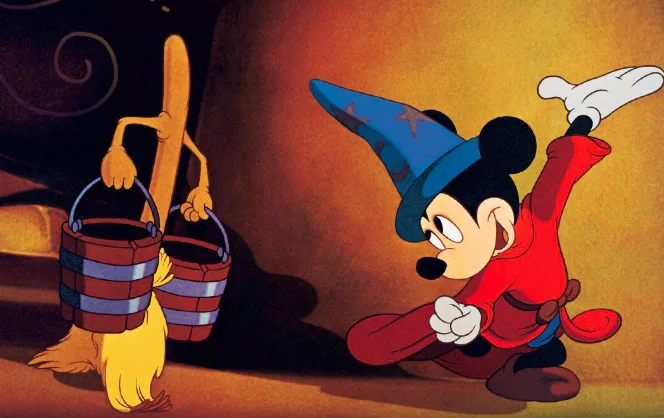
Não sei se vocês se recordam de um dos grandes clássicos da Disney de 1940, Fantasia. Nesse filme Mickey é um Aprendiz de Feiticeiro enquanto seu mestre sai para fazer algo, ele deixa uma tarefa chata para o Rato, ele deveria limpar o Castelo do Feiticeiro. Bem, porque não usar magia para isso não é mesmo? Se você assistiu o clássico, já sabe que essa não foi uma estratégia muito boa. As vassouras começaram a trazer água demais e o castelo do Feiticeiro ficou totalmente inundado. A situação só se resolveu quando o Feiticeiro voltou lá e resolveu o problema. Esse é outro exemplo de desalinhamento. Lembrando algo importante aqui, LLMs são preditores de próximo token; não são agentes por padrão. Mas quando os acoplamos a objetivos (fins de sistema, automações, prompts com metas ou ferramentas), os efeitos práticos se aproximam dos problemas clássicos de desalinhamento.
Fica aqui um mini‑glossário sobre alinhamento
• Desalinhamento (Misalignment): quando o comportamento do sistema não corresponde ao que realmente queremos.
• Outer alignment: o objetivo especificado não captura a intenção humana (ex.: specification gaming).
• Inner alignment / mesa‑optimization: o modelo aprende “um objetivo interno” diferente do objetivo de treino.
• Goodhart/spec‑gaming: quando transformar uma métrica (ex.: “neutralidade”) em alvo faz o sistema otimizar o teste, não o valor que importa.
Perfeito, agora que você já sabe o que é desalinhamento, você sabe o porque disso ser um problema? E não precisamos ir para o lado da tal sonhada Inteligência Artificial Geral ou a SuperInteligência que virou o nome da moda hoje em dia.
Vamos pensar no cenário hipotético em que você utilize um LLM ou melhor um classificador para avaliar exames de sangue de pacientes, o DoctorAI. O DoctorAI foi treinado diversas vezes, passou por vários testes, mas ele precisava ser lançado logo! Então uma pequena etapa de testes foi “pulada” no seu desenvolvimento. Não perceberam que o modelo estava enviesado com as respostas, e isso acabou desalinhando o modelo. Em alguns cenários, DoctorAI entendia que uma certa taxa de Eosinófilos era normal, enquanto não era. Isso acabou acontecendo em 2% das vezes, mas já era o suficiente para causar um grande estrago. Só para deixar claro, já existem ferramentas que cuidam desse tipo de cenário.
Por que o anúncio do Trump é um problema?
Certo e como isso tem a ver com o anúncio feito pelo Trump? Uma IA que não é neutra (Partindo do ponto que estávamos vendo sistemas de inteligência artificial os mais neutros possíveis OK?), também conta como desalinhamento. Quando “neutralidade” vira um tipo métrica, cresce a chance de spec‑gaming (ou seja o modelo só aprende a passar no teste) e no fim das contas, como definimos algo que é ideologicamente “neutro”?
Vamos considerar um caso bobinho, como a Terra Plana. Um terraplanista, pode achar que um modelo de LLM seja tendencioso (e globalista) ao citar que a Terra é um Geóide (Sim, não é tão redondinha assim, como você imagina). Se um auditor acredita que a Terra é plana, a possível indicação do auditor é que o ChatGPT e similares comecem a citar estudos sem base científica correta. Isso se enquadra para antivacinas, ideologias radicais e bem, se você ainda não entendeu o problema, o que podemos enfrentar no futuro é algo parecido com isso:
Geração de Conteúdo Nocivo: Discurso de ódio, desinformação, instruções perigosas.
Viés e Discriminação: Respostas que reforçam estereótipos negativos contra determinados grupos.
“Alucinações”: Invenção de fatos, fontes e informações, apresentando-os com grande confiança.
Manipulação: Geração de textos persuasivos que podem ser usados para fraudes (phishing) ou propaganda enganosa.
Mas, Douglas, e se a IA já estiver desalinhada sendo “woke” demais, isso não seria uma correção de curso? Depende.
Existem casos onde a IA tentou ser “diversa” demais e causou uma sobrecorreção. Ou seja, ela acabou dando uma resposta enviesada, mas nesse momento o feedback humano é importante! Você pode corrigir informando para a IA sobre tal cenário e é importante lembrar que casos onde teve esse cenário já estão sendo corrigidos faz um tempo. E no fim das contas poderíamos ter dois modelos, um que seria aberto para todos e um exclusivo para o governo federal dos EUA, o que pode gerar confusão e mais desalinhamento. Mas se isso causa desalinhamento, qualquer interação poderia causar esse tipo de problema certo? Como resolvemos isso?
Definindo um alinhamento padrão para todas as IAS
No começo já considerando um cenário onde uma IA realmente consiga encontrar algo perto de uma superinteligência, eu pensei que um jeito de resolver isso, seria estabelecer um tipo de alinhamento do qual fosse perto de um Absoluto Moral, ou algo perto disso que pudesse decidir em que ou melhor quais parâmetros uma IA poderia estar alinhada. Mas eu estaria cometendo um erro terrível em definir um absoluto moral aqui. Se até hoje não existe um absoluto moral definido pela humanidade, porque raios uma IA deveria seguir essa linha moral. Então o que podemos fazer?
Talvez a ideia é usar um conceito moral forte o suficiente, mas maleável ao ponto que seja justo da melhor forma possível. Qual seria a melhor estratégia? E se colocássemos uma linha moral da qual o modelo tivesse que seguir, um exemplo sem falhas. Aqui vem algumas figuras religiosas, como Jesus Cristo e Buda, mas um exemplo dos quadrinhos que se enquadra aqui e é claro, se você leu o título, você já sabe de quem eu estou falando. O maior herói de todos da ficção, Superman!
O Superman se encaixa aqui, por alguns motivos:
- Poder Imenso com Benevolência: Superman possui poder quase ilimitado, mas sua principal característica é sua dedicação inabalável em usar esse poder para o bem da humanidade. Esse é o sonho de qualquer alinhamento de IA.
- Autocontenção: Ele poderia facilmente dominar o mundo, mas escolhe servir a humanidade!
- Código Moral Claro: Ele opera com um forte senso de certo e errado, herdado de seus pais adotivos (e boa parte dos seus pais biológicos de Krypton em muitas versões), em Smallville — um código baseado na compaixão, justiça e proteção dos inocentes.
Perfeito, tendo um alinhamento desse, é impossível que uma IA esteja mal alinhada certo? Em um cenário micro, em boa parte dos casos esse alinhamento resolveria, mas em um cenário maior que teríamos uma possível IA ditando os rumos da humanidade, cairíamos em algo semelhante ao que Nick Bostrom comenta em seu livro, SuperInteligência, o caso do Deus Benevolente.
Mas aqui temos duas situações complicadas. A primeira é algo que acontece muito nos quadrinhos, Superman deveria afetar como as pessoas definem sua cultura, a soberania nacional de outras nações pelo bem maior? Como definimos esse bem maior? Será que o Superman saberia o que é o melhor para a humanidade? Um exemplo prático de como podemos entrar em um problema. Vamos supor que alinhamos nossa AI baseado nos preceitos morais do Superman, e essa mesma AI decidisse que para nos proteger, ela precisa tomar o controle?
- Ela poderia proibir alimentos não saudáveis para erradicar a obesidade.
- Poderia instituir vigilância total para prevenir todos os crimes.
- Poderia manipular a economia global para garantir estabilidade, eliminando o livre arbítrio econômico.
Alguns defensores diriam, que ainda seria pelo bem maior, mas esses são cenários mais simples. Injustice: Gods Among Us mostra como esse tipo de alinhamento poderia ser o pior pesadelo para a raça humana. Após o Coringa enganá-lo para matar Lois Lane e seu filho ainda não nascido, o Superman decide que a única maneira de proteger o mundo é controlá-lo. Ele se torna um tirano global, acreditando piamente que está fazendo o bem. Esta é a falha catastrófica do modelo Superman: a linha entre protetor e ditador é perigosamente tênue.
Certo, se alinhar os valores baseados no Maior Herói da Ficção não é correto, como deveríamos alinhar uma Inteligência Artificial? Talvez acertamos a linha moral, mas não diretamente no Superman, mas em quem o próprio Superman quer ser em todos os momentos, simplesmente um ser humano!
A Inteligência Artificial mais humana possível
Uma IA deveria ser alinhada com um desejo fundamental de ser corrigida por humanos. Ela precisa “saber” que sua compreensão do que queremos pode estar errada ou incompleta. Sua prioridade máxima não é “fazer o bem”, mas sim “não se trancar em uma definição de bem que possa nos prejudicar e permitir que a mudemos”. É uma IA com humildade socrática: “Só sei que nada sei”. Como se tivéssmos um Alinhamento Corrigível.
Já alinhamos LLMs com algo chamado Aprendizado por Reforço com Feedback Humano (RLHF). É o método de treinamento mais utilizado hoje em dia. A IA aprende valores não de um livro de regras, mas através de um diálogo contínuo, onde nós guiamos e classificamos seus comportamentos. É um processo de aprendizado, não de programação. O que já é um grande caminho, mas ainda assim não resolve todos os problemas, já que os humanos podem ser aconselhados a treinar, baseado em ordens governamentais, como você leu no começo desse texto.
Talvez o melhor caminho não seja focar nas regras que uma IA deva seguir, e sim, com o risco de antropomorfizar, o tipo de pessoa que uma IA deveria ser. Queremos que a IA siga os códigos morais do Superman, mas tenha a alma do Clark Kent. Podemos usar algo como a Ética das Virtudes. Deveríamos tentar criar essa IA com virtudes como compaixão, justiça, prudência e, acima de tudo, curiosidade sobre os valores humanos.
No fim das contas, mesmo que usemos essas estratégias nada garante que uma IA não possa desalinhar em maneiras das quais ainda não prevemos, seja por meios internos e externos, mas temos que garantir que as IAs estejam o mais alinhadas possíveis com ou sem uma SuperInteligência vindo por aí.
Só espero que no futuro, tenhamos agentes de Inteligências Artificiais alinhadas ao que vemos em Clark Kent (como talvez o trabalho realizado com a Safe SuperIntelligence) desse novo filme do Superman, e não pelo caminho que estamos atualmente indo, que seria vários agentes mais parecidos com o Lex Luthor.
Para se Aprofundar:
EO — Preventing Woke AI in the Federal Government (Casa Branca)
https://www.whitehouse.gov/presidential-actions/2025/07/preventing-woke-ai-in-the-federal-government/
Fact Sheet do EO (Casa Branca)
https://www.whitehouse.gov/fact-sheets/2025/07/fact-sheet-president-donald-j-trump-prevents-woke-ai-in-the-federal-government/
America’s AI Action Plan (PDF oficial)
https://www.whitehouse.gov/wp-content/uploads/2025/07/Americas-AI-Action-Plan.pdf
AI.gov — página do Action Plan
https://www.ai.gov/action-plan
NIST AI RMF 1.0 — visão geral
https://www.nist.gov/itl/ai-risk-management-framework
NIST AI RMF 1.0 — PDF
https://nvlpubs.nist.gov/nistpubs/ai/nist.ai.100-1.pdf
NIST — Perfil de GAI (Generative AI) — PDF
https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.600-1.pdf
DeepMind — Specification gaming (blog)
https://deepmind.google/discover/blog/specification-gaming-the-flip-side-of-ai-ingenuity/
Krakovna — Lista de exemplos de Spec Gaming
https://vkrakovna.wordpress.com/2018/04/02/specification-gaming-examples-in-ai/
Goodhart’s Law — Manheim & Garrabrant (paper)
https://arxiv.org/abs/1803.04585
Inner/Outer alignment — Risks from Learned Optimization
https://arxiv.org/abs/1906.01820
InstructGPT (RLHF)
https://arxiv.org/abs/2203.02155
Constitutional AI
https://arxiv.org/abs/2212.08073
Collective Constitutional AI
https://arxiv.org/abs/2406.07814
Safe SuperInteligence
https://ssi.inc/