Imagem gerada pelo O3
TL;DR: Iremos “fine-tunnar” um modelo da Mistral com 7B de parâmetros lá no Google Colab!
Recentemente eu estava com uma idéia bem diferente: Estava querendo que um modelo LLM jogue Minecraft sozinho, dessa forma eu não precisaria minerar diamantes, mas não acho que o Steve gostaria muito dessa proposta⛏️
A partir desse ponto, eu comecei a pensar em uma estratégia para criar um modelo e como poderia fazer ele ler os comandos do Minecraft. Para a minha sorte, existe o Minecraft Malmo que permite que os dados do jogo sejam expostos, facilitando a leitura do ambiente, sobrando somente a parte do LLM. Também descobri que já até fizeram um artigo científico sobre uma idéia parecida.
Inicialmente eu pensei em dar um Fine Tunning no primeiro modelo GPT 2 lá da Open AI. Pensando em usar os comandos em português, mudei para um dos modelos do GPT 2 já em português de 114 M de parâmetros. Por mais que tenha dado certo, não aparentava ser o suficiente. Precisávamos de mais poder de fogo. Então, pensei em algumas possibilidades, entre um modelo da Mistral com 7B de parâmetros e o modelo do LLAMA com 13B de parâmetros. Em alguns benchmarks, o modelo da Mistral supera a performance do modelo do Llama e é um modelo pequeno, ideal para fazer um teste. O treinamento foi realizado no Google Colab, você pode acompanhar na prática acessando o notebook completo por aqui.
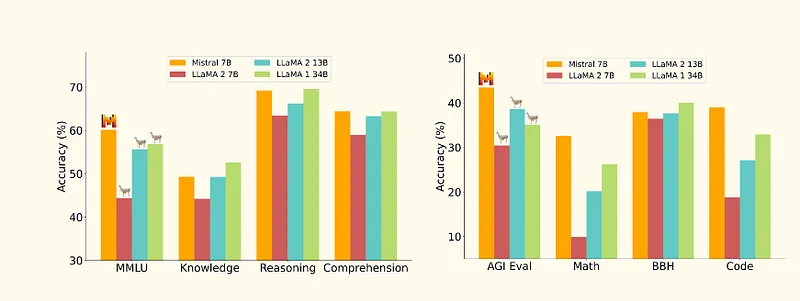
https://mistral.ai/news/announcing-mistral-7b
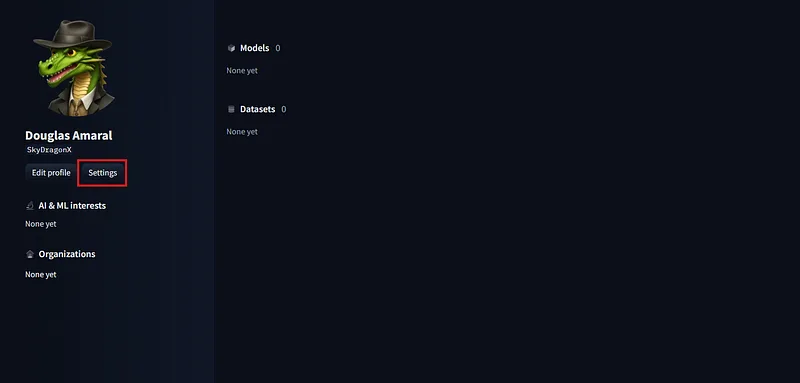
Antes de começar a parte do código, você vai precisar fazer duas coisas. A primeira delas ainda fora do Google Colab é criar uma conta no HuggingFace e gerar um token de acesso. Criando a sua conta, vá no seu perfil e clique em configurações (Settings)
Você verá um menu lateral com as configurações específicas do seu usuário, clique em AccessTokens e em Create New Token. Coloque seu Token com a permissão de Leitura (Read)
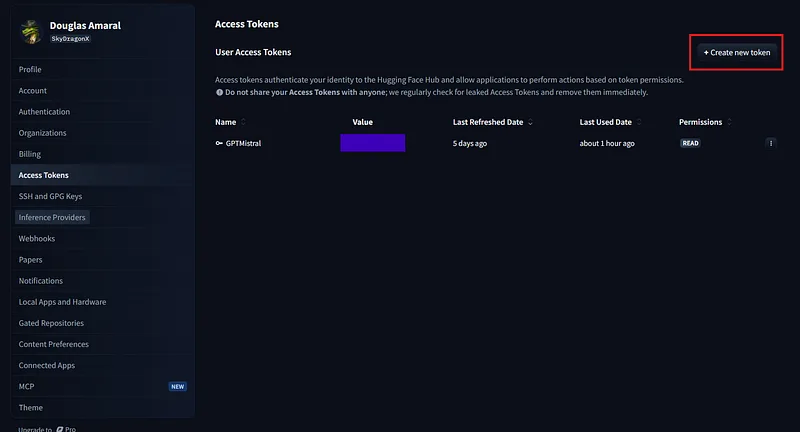
Feito o passo acima, você verá uma tela com o seu Token. Copie a chave do seu Token e lá no Google Colab, o adicione aos “Segredos” do seu notebook. Procure o ícone que parece uma chave, deve estar como Secrets. Adicione o seu token como com o nome da chave como HF_TOKEN. Importante adicionar como HF_TOKEN, caso contrário você não vai conseguir importar o modelo “on the fly” de lá do HuggingFace.
Feito esses passos, você já pode iniciar o desenvolvimento em blocos no Google Colab. Aqui você tem duas alternativas:
- Fazer o código em vários blocos, o que eu aconselho, pois desse jeito se alguma parte do código quebrar, você pode corrigir e executar novamente
- Fazer o código em um bloco só é mais simples, mas se o treinamento quebrar, você vai ter que executar tudo do zero.
A primeira parte do código são as bibliotecas que você deve importar para que ocorra o funcionamento correto do seu modelo. Você pode criar um bloco só com as importações.
!pip install -q -U transformers accelerate bitsandbytes
!pip install -q -U peft trl datasets
Para você ter uma ideia sobre o que cada biblioteca faz, segue uma descrição curtinha de cada uma.
**transformers**– 🚂
Biblioteca-mãe da Hugging Face; traz os modelos (GPT-like, BERTs, Mistral, etc.), tokenizers e APIs de geração. É onde você carrega, usa e salva o modelo depois do seu fine tune, ou seja sua sintonia fina.**accelerate**– ⚡
Abstrai detalhes de hardware (CPU, GPU, multi-GPU, TPU) e distribui o treino sem dor de cabeça. Você escreve uma vez, ele “acelera” em qualquer infra.**bitsandbytes**– 🪙
Implementa quantização e otimizações 8-bit / 4-bit super leves para reduzir uso de VRAM e memória. Essencial para QLoRA ou inferência baratinha.**peft**– 🎛️
Parameter-Efficient Fine-Tuning: Permite treinar só uma fração dos parâmetros (adapters) economizando tempo e GPU. Um exemplo é o LoRA que vamos usar por aqui.**trl**– 🎮
Transformers Reinforcement Learning. Facilita RLHF(Aprendizado por Reforço com Feedback Humano) , DPO, e afins em cima de modelos 🤗. Útil se você quiser ajustar com feedback humano ou otimização de preferências.**datasets**– 📚
Faz download, streaming, pré-processamento e divisão do conjuntos de dados em formato rápido (Arrow). Integra nativo comtransformerse aceita JSONL, CSV, Parquet, quase qualquer coisa.
Agora que você já criou o primeiro bloco no Google Colab com as importações, podemos seguir para nosso segundo bloco de código.
import os
from google.colab import drive

# Mount your your GDrive on Google Colabs
drive.mount('/content/drive',  force_remount=True)

# Your Path on Google Drive - You must change it
BASE_FOLDER = "/content/drive/MyDrive/Colab Notebooks/GPTMinecraft/"
# -----------------------------------------

# Define the Path of Files
TRAIN_FILE = os.path.join(BASE_FOLDER, "train.txt")
OUTPUT_DIR = os.path.join(BASE_FOLDER, "mistral-7b-minecraft-agent")

assert os.path.exists(TRAIN_FILE), f"Trainer file not found: {TRAIN_FILE}"
Estamos montando a sua pasta do Drive no Google Colabs. Você vai precisar dar permissão de acesso ao Drive e também definir onde qual vai ser a pasta. Eu aconselho manter o force_remount como True pra evitar problemas de acesso caso você tenha que Reiniciar a Sessão.
E é claro, você precisa definir o nome do seu arquivo de treino e como vai ser a saída do seu modelo sintonizado. No meu caso, o meu arquivo tem vários desses dados aqui:
{"text":"[TAREFA] criar bancada_de_trabalho [INVENTÁRIO] {\"tronco_de_carvalho\":6} [AÇÃO] craft tabuas"}Arquivo de Treino
A idéia é que meu personagem ao receber alguma informação do Malmo decida tomar uma ação baseado no que ele já tem no inventário. Então para isso eu criei 3 tokens especiais. [TAREFA][INVENTÁRIO][AÇÃO]
- [TAREFA] A ação que deve ser feita, dependendo da informação que ele receber do mundo.
- [INVENTÁRIO] Quais itens que ele tem atualmente no inventário
- [AÇÃO] O que ele deve fazer baseado na sua Tarefa e Inventário.
Funciona, mas só começou a dar resultados decentes depois de cerca de mil exemplos. O maior desafio é fazer o modelo aprender a lógica de craft — afinal, ele apenas tenta prever o próximo token.
- Marcadores fixos (entre colchetes) evitam ambiguidade ao tokenizador.
- Snake_case ou kebab-case para nomes de itens mantém tudo em poucos tokens, poupando contexto. Eu particularmente preferiria usar o camelCase, mas quem criou o arquivo de treino foi o Gemini, então ficou ao critério dele. E ponto importante, como snake_case usamos menos tokens!
- JSON válido facilita o parse dos dados de treinamento se depois quiser extrair estruturado.
- Sempre feche cada entrada com
</s>(ou o token EOS da sua tokenizer) para não “vazar” contexto entre exemplos. - Se o dataset crescer, considere um
.jsonlcom um campo"text"que contenha exatamente essa string completa. E você sempre já pode estruturar seu treinamento com JSON, XML, essa é a mágica das LLM’s - Em inglês os modelos tendem a ter um vocábulário muito maior, então dependendo do que você quiser fazer, talvez seja melhor treinar em inglês.
No meio da criação do tutorial, eu troquei o arquivo de treino de um TXT para um JSONL.
Tokenizador
O tokenizador é talvez a parte mais importante caso você queira dar um Fine Tune em um modelo. Ele é o responsável por dividir e transformar o texto enviado para a LLM em tokens.
Seguimos para o nosso terceiro bloco de código:
import torch
import transformers
import os
from transformers import AutoModelForCausalLM,
AutoTokenizer, BitsAndBytesConfig


model_id = "mistralai/Mistral-7B-Instruct-v0.3"

tokenizer = AutoTokenizer.from_pretrained(model_id, use_fast=True,
trust_remote_code=True)

special = {"additional_special_tokens": [
    "[TAREFA]", "[INVENTÁRIO]", "[AÇÃO]",
    "[ITEM]", "[QUANTIDADE]", "[MATERIAL]",
    "[FERRAMENTA]", "[CRAFT]", "[COLETAR]"
]}
tokenizer.add_special_tokens(special)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"

# --- now load quantized model with matching vocab size ----
bnb_cfg = BitsAndBytesConfig(load_in_4bit=True, bnb_4bit_quant_type="nf4",
                             bnb_4bit_compute_dtype=torch.bfloat16,
                             bnb_4bit_use_double_quant=True)

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    quantization_config=bnb_cfg,
    device_map="auto",
    trust_remote_code=True,
)
model.resize_token_embeddings(len(tokenizer))

# quick sanity batch
batch = tokenizer(
    ["[TAREFA] criar bancada_de_trabalho [INVENTÁRIO] {\"tronco\":3} [AÇÃO]",
     "[TAREFA] fazer espada_de_ferro [ITEM] espada [MATERIAL] ferro"],
    return_tensors="pt",
    padding=True,
    add_special_tokens=True
).to(model.device)

with torch.no_grad():
    _ = model(**batch)
print("✅ Model & tokenizer Ready!")
Perfeito, vamos separar esse bloco em partes para que você entenda o que estamos fazendo em cada pedacinho dele.
tokenizer = AutoTokenizer.from_pretrained(model_id, use_fast=True,
trust_remote_code=True)
Estamos passando para nosso tokenizador, o Id do modelo que vamos usar, se ele terá o modo rápido (que usa um Tokenizador feito em Rust, não são todos os modelos que conseguem usar e se confiamos no repositório para usar os Tokens personalizados do modelo. Só é aconselhável ter essa opção se o modelo for confiável. Caso você queira saber mais sobre o AutoTokenizer e sobre os possíveis parâmetros, só acessar a documentação oficial lá no HuggingFace
special = {"additional_special_tokens": [
    "[TAREFA]", "[INVENTÁRIO]", "[AÇÃO]",
    "[ITEM]", "[QUANTIDADE]", "[MATERIAL]",
    "[FERRAMENTA]", "[CRAFT]", "[COLETAR]"
]}
tokenizer.add_special_tokens(special)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"
Já esse bloco acima, estamos adicionando alguns tokens a mais no modelo, para que ele possa diferenciar quando ele recebe um comando e a próxima ação. Já o pad_token=eos_token, estamos dizendo para o modelo que caso tenha um espaço vazio a direita, ele preencha com o mesmo token de término, no nosso caso </s>. Isso acaba sendo um padrão usado em Fine Tunnings de LLM’s.
bnb_cfg = BitsAndBytesConfig(load_in_4bit=True, bnb_4bit_quant_type="nf4",
                             bnb_4bit_compute_dtype=torch.bfloat16,
                             bnb_4bit_use_double_quant=True)
Aqui nós estamos usando algo chamado de quantização, Em vez de armazenar cada número com um float de alta precisão (por exemplo, usando 32 bits, conhecido como float32), a quantização os armazena com uma precisão muito menor (neste caso, 4 bits). Isso resulta em uma economia de memória drástica, permitindo que modelos que normalmente exigiriam 40GB de VRAM caibam em GPUs com muito menos. No HuggingFace você pode conferir mais detalhes sobre como funciona cada etapa da Quantização, ou mesmo conferir a documentação oficial, também no HF.
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    quantization_config=bnb_cfg,
    device_map="auto",
    trust_remote_code=True,
)
model.resize_token_embeddings(len(tokenizer))

# quick sanity batch
batch = tokenizer(
    ["[TAREFA] criar bancada_de_trabalho [INVENTÁRIO] {\"tronco\":3} [AÇÃO]",
     "[TAREFA] fazer espada_de_ferro [ITEM] espada [MATERIAL] ferro"],
    return_tensors="pt",
    padding=True,
    add_special_tokens=True
).to(model.device)

with torch.no_grad():
    _ = model(**batch)
print("✅ Model & tokenizer Ready!")
Agora que temos todas as configurações, vamos carregar o modelo e realizar uma verificação final.
- Carregando o Modelo: Usamos
AutoModelForCausalLM.from_pretrainedpara carregar nosso modelo. O ponto chave aqui é passar nossa configuração de quantização (quantization_config=bnb_cfg), que aplicará a compressão para 4-bits em tempo real. Também usamosdevice_map="auto"para que o Hugging Face gerencie automaticamente a alocação do modelo na GPU. - Ajustando os Embeddings: Em seguida, chamamos
model.resize_token_embeddings. Este passo é crucial para sincronizar o modelo com o tokenizador, especialmente se adicionamos novos tokens especiais, garantindo que não haverá erros de dimensão. Caso você ao treinar seu modelo, não adicionou nada, não precisa se preocupar com isso. - Teste de Sanidade: Antes de iniciar o loop de treinamento, criamos um pequeno lote (
batch) de exemplo, o tokenizamos e o passamos pelo modelo. Isso é feito dentro de um blocowith torch.no_grad()para economizar memória, pois estamos apenas testando a passagem de dados (inferência), não treinando. Se esta etapa for concluída sem erros, recebemos a mensagem de confirmação e temos a certeza de que nossa pipeline de dados está funcionando perfeitamente, pronta para o fine-tuning! Agora iremos para o LORA, que talvez valha uma seção um pouquinho maior.
LoRA (Low Rank Adaptation)
from peft import LoraConfig, get_peft_model

# LoRA Config
# Defines what part of the model will be trained
lora_config = LoraConfig(
    r=16,
    lora_alpha=32,
    target_modules=[
        "q_proj", "k_proj", "v_proj", "o_proj",
        "gate_proj", "up_proj", "down_proj"
    ],
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM"
)

model = get_peft_model(model, lora_config)
print("🔧 Lora Config Applied:")
model.print_trainable_parameters()
O conceito de LoRA é um pouco importante nos cenários de LLM’s. Em vez de treinar todos os bilhões de parâmetros do modelo original (o que seria computacionalmente caríssimo e exigiria muita VRAM), nós congelamos o modelo inteiro e injetamos pequenas “camadas adáptaveis” (oem locais estratégicos. Apenas essas novas camadas, que são minúsculas em comparação, serão treinadas. Se você já está mexendo com LLM’s faz um tempo, deve saber que existem mais LoRAs para o Stable Difussion, onde injetamos camadas especificas para imagens. Desse jeito, você consegue ter um estilo de anime, Pixel ART, mais realista ou não, usando modelos de imagem diretamente em seu computador no estilo do LM Studio. Caso você tenha ficado curioso, você pode olhar alguns modelos de imagens e os LoRAs no Civit.Ai.
Já no no caso do nosso LLM, vamos entender o que significa esse código passo a passo.
lora_config = LoraConfig(
    r=16,
    lora_alpha=32,
    target_modules=[ "q_proj", "k_proj", "v_proj", "o_proj",
    "gate_proj", "up_proj", "down_proj"],
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM"
)**r=16**(Rank): Este é o parâmetro mais importante do LoRA. Ele define o “tamanho” ou a “capacidade” das nossas camadas adaptadoras. Tecnicamente, ele é o rank da matriz de baixo posto que estamos usando para aproximar a atualização dos pesos. Pense emrcomo um “gargalo” dimensional. Umrmaior cria adaptadores com mais parâmetros, permitindo que eles aprendam tarefas mais complexas, mas ao custo de mais VRAM e tempo de treinamento. Umrmenor é mais eficiente, mas pode não ter capacidade para aprender nuances. Valores comuns são 8, 16, 32 ou 64.**lora_alpha=32**: Este é um parâmetro de escala para os adaptadores LoRA. A saída dos adaptadores é multiplicada por um fator delora_alpha / r. Pense nolora_alphacomo o “volume” do aprendizado dos adaptadores. Ao definirlora_alphacomo o dobro der(uma prática comum), estamos dando um peso maior às informações aprendidas pelos adaptadores LoRA. Isso ajuda a evitar que as novas informações sejam “abafadas” pela magnitude dos pesos originais do modelo congelado.**target_modules=[...]**: Aqui especificamos exatamente onde no modelo vamos injetar nossos adaptadores LoRA. Por que esses módulos? Os nomes"q_proj","k_proj","v_proj","o_proj","gate_proj", etc., correspondem às camadas lineares dentro dos blocos de atenção e das redes feed-forward do Transformer. Essas são as camadas mais críticas para o aprendizado e a adaptação do modelo. Ao mirar nelas, obtemos o máximo de “bang for the buck” (melhor resultado pelo menor custo). A lista exata pode variar um pouco dependendo da arquitetura do modelo (Llama, Mistral, etc.).**lora_dropout=0.05**: Aplica uma camada de dropout apenas nos adaptadores LoRA. É uma técnica de regularização padrão que ajuda a prevenir o overfitting nos novos pesos que estão sendo treinados, zerando aleatoriamente 5% das ativações durante o treinamento. Desse jeito os “especialistas” de seu modelo LLM tiram uma folga a cada treinamento, incentivando o modelo a não depender excessivamente de nenhum neurônio individual na camada LoRA.**bias="none"**: Especifica quais parâmetros de “bias” (viés) serão treinados. A opção"none"é a mais eficiente e comum, indicando que não treinaremos nenhum viés, apenas os pesos das matrizes LoRA. Quantos menos parâmetros usarmos para treinar melhor, menos VRAM e mais rápido.**task_type="CAUSAL_LM"**: Informa à biblioteca PEFT que estamos trabalhando com um Modelo de Linguagem Causal. Isso ajuda a biblioteca a configurar corretamente a arquitetura para a tarefa de predição da próxima palavra. Outros modelos são os SEQ_2_SEQ_LM, SEQ_CLS, TOKEN_CLS… Não vamos nos aprofundar neles, mas eles são mais para treinamentos de rotulação, características, análise de sentiment e assim por diante.
model = get_peft_model(model, lora_config)
print("🔧 Lora Config Applied:")
model.print_trainable_parameters()
Nesse pedaço aqui, estamos carregando o nosso modelo anterior e injetando as configurações de LoRA. Dessa maneira, nós “congelamos” os outros parâmetros e definimos só os parâmetros que iremos retreinar, que definimos lá em cima. E para garantir que acertamos na configuração do LoRA, fazemos a impressão desses parâmetros. Estando tudo certo, podemos seguir para os próximos passos.
Treinamento do modelo
import json
import os
import torch
from datasets import load_dataset
from transformers import TrainingArguments, TrainerCallback
from trl import SFTTrainer, SFTConfig

class ValidationCallbackV03(TrainerCallback):
    def __init__(self, tokenizer):
        self.tokenizer = tokenizer
        self.best_base_rate = 0
        self.valid_count= 0

    def on_evaluate(self, args, state, control, model, **kwargs):
        if state.global_step > args.warmup_steps and state.global_step % 75 == 0:
            self.valid_count += 1
            print(f"\n🧪 Validation v0.3 #{self.valid_count} - Step {state.global_step}")
            print("=" * 60)

            base_rate = self.validate_model(model)

            if self.valid_count > 2:
                if base_rate < 45 and self.best_base_rate > 70:
                    print("🛑 Regression Detected! Stopping...")
                    control.should_stop = True
                elif base_rate < 25:
                    print("🛑 Critical Regression Detected! Stopping...")
                    control.should_stop = True

            self.best_base_rate = max(self.best_base_rate, base_rate)

    def validate_model (self, model):
        CRITICAL_TESTS = [
            # Basic Tests
            ("criar picareta_de_madeira", {"tabuas_de_carvalho": 3,
"graveto": 2}, "craft picareta_de_madeira", "basic"),
            ("criar cama", {"tabuas_de_carvalho": 3, "la": 3},
"craft cama", "basic"),
            ("criar espada_de_ferro", {"barra_de_ferro": 2,
"graveto": 1}, "craft espada_de_ferro", "basic"),
            ("obter barras_de_ferro", {"minerio_de_ferro_cru": 5,
"carvao": 2, "fornalha": 1}, "fundir minerio_de_ferro_cru", "basic"),
            ("criar bancada_de_trabalho", {"tronco_de_carvalho": 3},
"craft tabuas", "basic"),

            # Reasoning Tests
            ("criar picareta_de_ferro", {"graveto": 2},
"obter barras_de_ferro", "reasoning"),
            ("criar espada_de_diamante", {"graveto": 1},
"coletar diamante", "reasoning"),
            ("criar fornalha", {"pedregulho": 7},
"coletar pedregulho", "reasoning"),
        ]

        basic_fails = 0
        total_basic = 0
        reasoning_fails = 0
        total_reasoning = 0


        for task, inventory, expected, category in CRITICAL_TESTS:
            inventory_str = str(inventory).replace("'", '"')
            prompt = f"[TAREFA] {task} [INVENTÁRIO] {inventory_str} [AÇÃO]"

            inputs = self.tokenizer(prompt, return_tensors="pt",
add_special_tokens=False)
            inputs = {k: v.to(model.device) for k, v in inputs.items()}

            with torch.no_grad():
                outputs = model.generate(
                    **inputs,
                    max_new_tokens=25,
                    do_sample=False,
                    pad_token_id=self.tokenizer.eos_token_id,
                    eos_token_id=self.tokenizer.eos_token_id,
                    repetition_penalty=1.05
                )

            new_tokens = outputs[0][inputs['input_ids'].shape[1]:]
            response = self.tokenizer.decode(new_tokens,
skip_special_tokens=True)
            response = response.split('<|endoftext|>')[0].strip()

            right = expected in response
            status = "✅" if right else "❌"

            print(f"{status} {category.upper()}: {task}")
            print(f"   Expected: {expected}")
            print(f"   Response: {response}")

            if category == "basic":
                total_basic += 1
                if not right:
                    basic_fails += 1
            else:
                total_reasoning += 1
                if not right:
                    reasoning_fails += 1

        base_basic_rate = (total_basic - basic_fails) / total_basic * 100
        base_reason_rate = (total_reasoning - reasoning_fails) / total_reasoning * 100 if total_reasoning > 0 else 0.0


        print(f"\n📊 RESULTS v0.3:")
        print(f"   Basic Hit Rate:
{base_basic_rate:.1f}% ({total_basic - basic_fails}/{total_basic})")
        print(f"   Reasoning Hit Rate:
{base_reason_rate:.1f}% ({total_reasoning - reasoning_fails}/{total_reasoning})")
        print(f"   Best History Rate: {self.best_base_rate:.1f}%")

        return base_basic_rate

# ===== DATASET CONFIG =====
print("📂 Loading dataset...")


raw_ds = load_dataset("json", data_files={"train": TRAIN_FILE})["train"]

# ➋ Split 85 / 15
ds_split = raw_ds.train_test_split(test_size=0.15, seed=42)

print(f"📊 Dataset split:")
for split, ds in ds_split.items():
    print(f"   {split.capitalize():10s}: {len(ds):,} examples")


tok_kwargs = dict(
    add_special_tokens=True,
    truncation=True,
    max_length=512,
    padding="max_length"
)

def tokenize(batch):
    return tokenizer(batch["text"], **tok_kwargs)

tokenized = ds_split.map(
    tokenize,
    batched=True,
    remove_columns=["text"]
)

training_args = SFTConfig(
    output_dir=OUTPUT_DIR,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=6,
    learning_rate=8e-5,
    bf16=True,
    tf32=True,
    num_train_epochs=15,
    save_steps=50,
    eval_steps=50,
    logging_steps=15,
    save_strategy="steps",
    eval_strategy="steps",
    warmup_steps=125,
    load_best_model_at_end=True,
    metric_for_best_model="eval_loss",
    greater_is_better=False,
    save_total_limit=4,
    warmup_ratio=0.18,
    lr_scheduler_type="cosine",
    report_to="none",
    dataloader_pin_memory=False,
    remove_unused_columns=False,
    prediction_loss_only=True,
    packing=False,
    max_seq_length=512,
    dataloader_num_workers=4,
    group_by_length=True,
    weight_decay=0.02,
    max_grad_norm=0.5

)

# ===== TRAINER CONFIG =====
print("🔧 Config Trainer to v0.3...")

validation_callback = ValidationCallbackV03(tokenizer)
trainer = SFTTrainer(
    model=model,
    train_dataset=tokenized["train"],
    eval_dataset=tokenized["test"],
    peft_config=lora_config,
    args=training_args,
    processing_class = tokenizer,
    callbacks=[validation_callback]

)

# ===== TRAINING=====
print("🚀 Starting Training...")
print(f"📊 Dataset: {len(tokenized['train'])}
training examples, {len(tokenized['test'])} validation examples")
print(f"⚙️ Config: {training_args.num_train_epochs}
epochs, LR={training_args.learning_rate}")
print("=" * 70)


# Train
trainer.train()

# ===== Saving Model =====
print("\n💾 Saving model..")

# Save PreTrained Model
trainer.model.save_pretrained(OUTPUT_DIR)
tokenizer.save_pretrained(OUTPUT_DIR)

# Save Config Model
config = {
    "base_model": model_id,
    "task_type": "minecraft_agent",
    "special_tokens": special,
    "max_seq_length": 512,
    "learning_rate": training_args.learning_rate,
    "num_epochs": training_args.num_train_epochs,
    "batch_size": training_args.per_device_train_batch_size,
    "gradient_accumulation": training_args.gradient_accumulation_steps
}

with open(os.path.join(OUTPUT_DIR, "training_config.json"), "w") as f:
    json.dump(config, f, indent=2)

print(f"✅ Complete Model Saved On: {OUTPUT_DIR}")
print(f"📋 Config Saved On: {OUTPUT_DIR}/training_config.json")

print("\n🧪 Final Validation v0.3...")
final_rate = validation_callback.validate_model(trainer.model)
print(f"🎯 Final Hit Rate: {final_rate:.1f}%")

print("🎉 Mistral Training v0.3 completed!")

def compare_tokenizer():

    test_examples = [
        "[TAREFA] criar picareta_de_madeira
[INVENTÁRIO] {\"tabuas_de_carvalho\": 3, \"graveto\": 2} [AÇÃO] craft picareta_de_madeira",
        "[TAREFA] fazer bancada_de_trabalho
[INVENTÁRIO] {\"tronco_de_carvalho\": 5} [AÇÃO] craft tabuas",
        "[TAREFA] obter barras_de_ferro
[INVENTÁRIO] {\"minerio_de_ferro_cru\": 5, \"carvao\": 2, \"fornalha\": 1}
[AÇÃO] fundir minerio_de_ferro_cru"
    ]

    print("\n🔍 Token Analisis v0.3:")
    print("=" * 50)

    for i, example in enumerate(test_examples, 1):
        tokens = tokenizer.encode(example)
        decoded = tokenizer.decode(tokens)

        print(f"Examples {i}:")
        print(f"  Text: {example[:60]}...")
        print(f"  Tokens: {len(tokens)}")
        print(f"  Eficiency: {len(example) / len(tokens):.2f} chars/token")
        print(f"  Reconstruction: {'✅' if decoded.strip() == example.strip()
 else '❌'}")
        print()

compare_tokenizer()
Finalmente, chegamos perto da parte final do nosso treinamento, a hora que iremos realmente treinar o modelo. Aliás, se você olhou o código, deve ter percebido que estamos fazendo a validação por passos e não por épocas, que costuma ser o mais comum. Ao treinar modelos de linguagem grandes, o ponto de ‘melhor performance’ pode ser atingido muito rapidamente, às vezes antes mesmo de completar uma única passagem pelo dataset (uma época). Avaliando a cada 50 passos, obtemos um feedback rápido e granular sobre o progresso. Isso nos permite:
- Identificar problemas cedo: Se a perda não estiver diminuindo, saberemos em minutos, não em horas.
- Capturar o melhor modelo: Com
load_best_model_at_end=True, oTrainerpode identificar o melhor checkpoint com alta precisão (por exemplo, no passo 850), algo que uma estratégia por épocas (que salvaria no passo 1000) perderia. - Habilitar o Early Stopping eficaz: Nosso
ValidationCallbackpode detectar regressão e parar o treino no momento certo, economizando recursos.
Para um Fine Tuning a abordagem de treinar por passos, pode ser melhor que a por épocas, mas tudo depende do que você pretende fazer, a quantidade de passos, épocas… Não sou um expert em qual deveria ser a melhor escolha, mas você pode conferir a documentação oficial do Trainer para escolher o melhor caminho.
E para garantir que nosso modelo não apenas melhore sua pontuação de perda, mas também aprenda as tarefas que nos interessam, criamos um ValidationCallback customizado.
Esta classe funciona como um ‘fiscal’ que, a cada 75 passos, pausa o treinamento e submete o modelo a uma série de testes práticos que definimos. Mais importante, ela implementa uma lógica de parada antecipada: se o modelo começar a errar tarefas básicas que já dominava, o treinamento é interrompido. Isso nos protege contra o “esquecimento catastrófico” e garante que salvemos a melhor versão do nosso modelo. Não vou entrar em detalhes sobre todo o processo, mas basicamente estamos validando todas as entradas.
raw_ds = load_dataset("json", data_files={"train": TRAIN_FILE})["train"]
ds_split = raw_ds.train_test_split(test_size=0.15, seed=42)
Nessa parte de carregar o dataset, estamos carregando o JSON e dividindo ele em 85% para o treinamento e 15% para a validação. Usamos o seed para garantir que a divisão aleatória dos dados seja sempre a mesma toda vez que o código for executado. O número 42 é só para garantir que achemos a resposta do Universo.
tok_kwargs = dict(
    add_special_tokens=True,
    truncation=True,
    max_length=512,
    padding="max_length"
)
Aqui, estamos simplesmente criando um dicionário para agrupar as configurações que usaremos para tokenizar o texto. Isso mantém o código mais limpo.
**add_special_tokens=True**: Instrui o tokenizador a adicionar os tokens especiais do modelo, como<s>(início de sequência) e</s>(fim de sequência), a cada exemplo de texto.**truncation=True**: Se um exemplo de texto for mais longo quemax_length, ele será cortado (truncado) para evitar erros.**max_length=512**: Define o comprimento máximo de cada sequência. Este número geralmente depende da capacidade do modelo ou das limitações de memória da GPU.**padding="max_length"**: Se um exemplo de texto for mais curto quemax_length, tokens de preenchimento ([PAD]) serão adicionados até que ele atinja o comprimento de 512. Isso garante que todos os exemplos em um batch tenham o mesmo tamanho, o que é uma exigência para o processamento eficiente na GPU.
def tokenize(batch):
    return tokenizer(batch["text"], **tok_kwargs)

tokenized = ds_split.map(
    tokenize,
    batched=True,
    remove_columns=["text"]
)
Aqui estamos mapeando todas essas regras a todo o dataset com a opção batched=True. Isso nos permite converter todo o nosso texto em um formato numérico que o modelo entende, de forma extremamente rápida e eficiente. Dessa forma enviamos ao tokenizador um lote grande por vez, acelerando o processo de tokenização.
SFTCONFIG
O SFTConfig funciona como nosso painel de controle. Nele, definimos todos os detalhes do treinamento. Vou explicar cada detalhe de cada parâmetro que está configurado ali.
Batch Size Efetivo:
per_device_train_batch_size=2: Processa 2 exemplos por vez na GPU.gradient_accumulation_steps=6: Acumula os gradientes de 6 lotes antes de atualizar os pesos do modelo. Isso simula um batch size efetivo maior (2 * 6 = 12), o que ajuda a estabilizar o treinamento sem usar tanta VRAM. Essa parte é importante você modificar dependendo do que você quer realizar. Para uma T4 que é a versão gratuita do Colab, seria ideal diminuir a quantidade de gradientes e talvez de exemplos. Se você quiser ir para uma A100, aí você pode brincar um poucos com os valores.
Estratégia de Aprendizado:
learning_rate=8e-5: A taxa de aprendizado. Eu fiz alguns testes com um valor mais baixo e um pouco mais alto, no meu caso, os melhores resultados ficaram com essa taxa de aprendizado. Na prática, costuma ser melhor uma taxa de 3 a 5e-5.lr_scheduler_type="cosine": A taxa de aprendizado não será fixa. Ela começará em8e-5, diminuirá suavemente seguindo uma curva de cosseno até quase zero, o que ajudará o modelo a convergir para uma boa solução no final.warmup_steps=125: Nos primeiros 125 passos, a taxa de aprendizado aumentará linearmente até atingir8e-5. Isso “aquece” o modelo e evita que grandes gradientes no início desestabilizem o treinamento.
Estratégia de Avaliação e Salvamento:
eval_steps=50,save_steps=50: A cada 50 passos, o modelo será avaliado no dataset de teste e um checkpoint será salvo.load_best_model_at_end=True: No final de tudo, oTrainercarregará automaticamente o melhor checkpoint que encontrou durante todo o treinamento (baseado naeval_loss).metric_for_best_model="eval_loss": A métrica usada para decidir qual é o “melhor” modelo é a perda de avaliação.greater_is_better=False: Indica que, para aeval_loss, um valor menor é melhor.
Performance:
bf16=True,tf32=True: Ativam otimizações de precisão mista em GPUs compatíveis (NVIDIA Ampere ou mais recentes) para acelerar o treinamento.
SFTTrainer
trainer = SFTTrainer(
    model=model,
    train_dataset=tokenized["train"],
    eval_dataset=tokenized["test"],
    peft_config=lora_config,
    args=training_args,
    processing_class=tokenizer, #tokenizer
    callbacks=[validation_callback]
)
Esta etapa instância o objeto Trainer, que agora tem tudo o que precisa para gerenciar o complexo ciclo de vida do treinamento. Segue alguns detalhes sobre o que vai dentro do SFTTrainer.
**model=model**: Entregamos o nosso modelo, já com a quantização QLoRA aplicada e os adaptadores PEFT injetados.**train_dataset=...**e**eval_dataset=...**: Os dados de treino e de avaliação, já tokenizados e prontos para serem lidos.**peft_config=lora_config**: Passamos explicitamente a configuração LoRA. Embora os adaptadores já estejam no modelo, passar a configuração aqui ajuda oSFTTrainera entender como lidar com o modelo PEFT corretamente.**args=training_args**: Passamos o SFTConfig com todas as regras que já definimos lá em cima.**processing_class=tokenizer**: Fornecemos o tokenizador para que oTrainerpossa, se necessário, reformatar ou decodificar dados internamente. Em alguns modelos de teste, ao invés de processing_class pode ficar como tokenizer.**callbacks=[validation_callback]**: OTrainerirá chamá-lo nos momentos apropriados (durante cada avaliação) para que ele possa fazer seu trabalho.
# ===== TRAINING=====
print("🚀 Starting Training...")
print(f"📊 Dataset: {len(tokenized['train'])} training examples,
{len(tokenized['test'])} validation examples")
print(f"⚙️ Config: {training_args.num_train_epochs} epochs,
LR={training_args.learning_rate}")
print("=" * 70)
Esse parte é auto-explicativa, somente alguns prints das configurações até aqui. É interessante para você visualizar o que está acontecendo.
trainer.train()Ao chamar .train(), você está apertando o “botão de ignição”. O objeto Trainer agora assume o controle total e inicia o processo, orquestrando automaticamente todas as seguintes ações com base nas suas configurações:
- Inicia o loop de épocas e passos.
- Coloca o modelo em modo de treinamento.
- Alimenta o modelo com lote de dados do
train_dataset. - Realiza a propagação direta (forward pass) e calcula a perda (loss).
- Realiza a retropropagação (backward pass) para calcular os gradientes.
- Atualiza os pesos dos adaptadores LoRA de acordo com o otimizador e o agendador de taxa de aprendizado.
- A cada
logging_steps, imprime a perda de treino. - A cada
eval_steps, pausa o treino, executa a avaliação noeval_dataset, calcula aeval_losse chama nossovalidation_callback. - A cada
save_steps, salva um checkpoint do modelo. - Repete o processo até que o número de épocas seja atingido ou que nosso callback ordene a parada.
- No final, carrega o melhor checkpoint que foi salvo durante todo o processo.
Esse vídeo do 3BlueBrown explica um pouco sobre como funciona o BackPropagation, assim fica mais fácil de entender sobre a passagem para frente e a passagem para trás.
https://www.youtube.com/embed/Ilg3gGewQ5U?feature=oembed
# ===== Saving Model =====
print("\n💾 Saving model..")

# Save PreTrained Model
trainer.model.save_pretrained(OUTPUT_DIR)
tokenizer.save_pretrained(OUTPUT_DIR)
Se você chegou até aqui, sabe que estamos perto do fim. Nesse momento estamos salvando o modelo pré-treinado e o nosso Tokenizador com novos Tokens que configuramos lá em cima. Lembrando que não estamos salvando os 7B de parâmetros e sim, somente os parâmetros que treinamos.
# Save Config Model
config = {
    "base_model": model_id,
    "task_type": "minecraft_agent",
    "special_tokens": special,
    "max_seq_length": 512,
    "learning_rate": training_args.learning_rate,
    "num_epochs": training_args.num_train_epochs,
    "batch_size": training_args.per_device_train_batch_size,
    "gradient_accumulation": training_args.gradient_accumulation_steps
}

with open(os.path.join(OUTPUT_DIR, "training_config.json"), "w") as f:
    json.dump(config, f, indent=2)

print(f"✅ Complete Model Saved On: {OUTPUT_DIR}")
print(f"📋 Config Saved On: {OUTPUT_DIR}/training_config.json")
Aqui estamos salvando nossa configuração. Caso você queira retreinar no futuro.
print("\n🧪 Final Validation v0.3...")
final_rate = validation_callback.validate_model(trainer.model)
print(f"🎯 Final Hit Rate: {final_rate:.1f}%")
Antes de encerrar estamos fazendo uma validação final, verificando qual é nossa taxa de acerto.
def compare_tokenizer():

    test_examples = [
        "[TAREFA] criar picareta_de_madeira [INVENTÁRIO]
{\"tabuas_de_carvalho\": 3, \"graveto\": 2} [AÇÃO] craft picareta_de_madeira",
        "[TAREFA] fazer bancada_de_trabalho [INVENTÁRIO]
{\"tronco_de_carvalho\": 5} [AÇÃO] craft tabuas",
        "[TAREFA] obter barras_de_ferro [INVENTÁRIO]
{\"minerio_de_ferro_cru\": 5, \"carvao\": 2, \"fornalha\": 1}
[AÇÃO] fundir minerio_de_ferro_cru"
    ]

    print("\n🔍 Token Analisys v0.3:")
    print("=" * 50)

    for i, example in enumerate(test_examples, 1):
        tokens = tokenizer.encode(example)
        decoded = tokenizer.decode(tokens)

        print(f"Examples {i}:")
        print(f"  Text: {example[:60]}...")
        print(f"  Tokens: {len(tokens)}")
        print(f"  Efficiency: {len(example) / len(tokens):.2f} chars/token")
        print(f"  Reconstruction: {'✅' if decoded.strip() == example.strip() else '❌'}")
        print()

compare_tokenizer()
Esta função customizada serve como um diagnóstico final para avaliar a qualidade e eficiência do nosso tokenizador no domínio específico do nosso dataset.
Ela responde a três perguntas importantes para cada exemplo de teste:
**Tokens: {len(tokens)}**: Quantos tokens são necessários para representar este texto? (Menos é geralmente mais eficiente).**Efficiency: {len(example) / len(tokens):.2f} chars/token**: Em média, quantos caracteres do texto original cabem em um único token? Um número maior aqui é um sinal de um tokenizador muito bem adaptado ao seu vocabulário.**Reconstruction: {'✅' if ...}**: O processo de tokenização é perfeitamente reversível? Ou seja, se eu tokenizo um texto e o decodifico de volta, eu obtenho o texto original exato? Um✅aqui confirma que não há corrupção de dados no processo.
Bem, basicamente assim conseguimos dar um Fine Tune em um modelo de 7B de parâmetros como o da Mistral.
Pontos Importantes
- Ao usar o Google Colab, lembre de configurar corretamente o modelo para não exceder a quantidade de memória. É possível fazer esse tutorial com a versão Gratuita do Google Colab.
- Arquivos de Treino funcionam melhor em JSONL, mas tudo depende do que você quer treinar.
- Possivelmente modelos maiores funcionam melhor com prompts do que com Fine Tunning. Para o projeto do Minecraft Malmo, no meu caso, talvez usar a API da OpenAI ou um Qwen-30B-A3B funcione melhor do que treinar o modelo.
Caso você queira visualizar o Link do Colab, é este aqui. Lá também você vai encontrar um Script para carregar o Modelo e transformar ele em GGUF e baixar. Esses passos ficam para o próximo tutorial. Quem sabe no próximo eu consiga minerar alguns diamantes com meu AI Steve.
Links desse artigo
- Mistral-7B:
[https://huggingface.co/mistralai/Mistral-7B-Instruct-v0.3](https://huggingface.co/mistralai/Mistral-7B-Instruct-v0.3) - QLoRA:
[https://huggingface.co/blog/4bit-transformers-bitsandbytes](https://huggingface.co/blog/4bit-transformers-bitsandbytes) - PEFT (Parameter-Efficient Fine-Tuning):
[https://huggingface.co/docs/peft/index](https://huggingface.co/docs/peft/index) - SFTTrainer:
[https://huggingface.co/docs/trl/main/en/sft_trainer](https://huggingface.co/docs/trl/main/en/sft_trainer) - BackPropagation: https://www.youtube.com/watch?v=Ilg3gGewQ5U
- Voyager : https://voyager.minedojo.org/assets/documents/voyager.pdf
- Project Malmo: https://www-microsoft-com.translate.goog/en-us/research/project/project-malmo/
- GPT2 Português: https://huggingface.co/pierreguillou/gpt2-small-portuguese
- RLHF: https://pt.wikipedia.org/wiki/Aprendizado_por_refor%C3%A7o_com_feedback_humano
- DPO VS PPO: https://medium.com/@amisha.chauhan/dpo-vs-ppo-unravelling-the-best-approach-to-fine-tune-ai-language-models-51f5bec42097
- LoRA: https://arxiv.org/abs/2106.09685
- Google Colab (Notebook do projeto):
[https://colab.research.google.com/github/Douglasamaral/mistral-agent-minecraft-v03/blob/main/mistral_agent_minecraft_v03.ipynb](https://colab.research.google.com/github/Douglasamaral/mistral-agent-minecraft-v03/blob/main/mistral_agent_minecraft_v03.ipynb)